AI 크롤러별 접근 규칙 확인하기
공식 문서의 수집기 이름을 robots.txt·서버·CDN 설정과 대조하고, 변경한 경로와 판단 근거를 기록합니다.
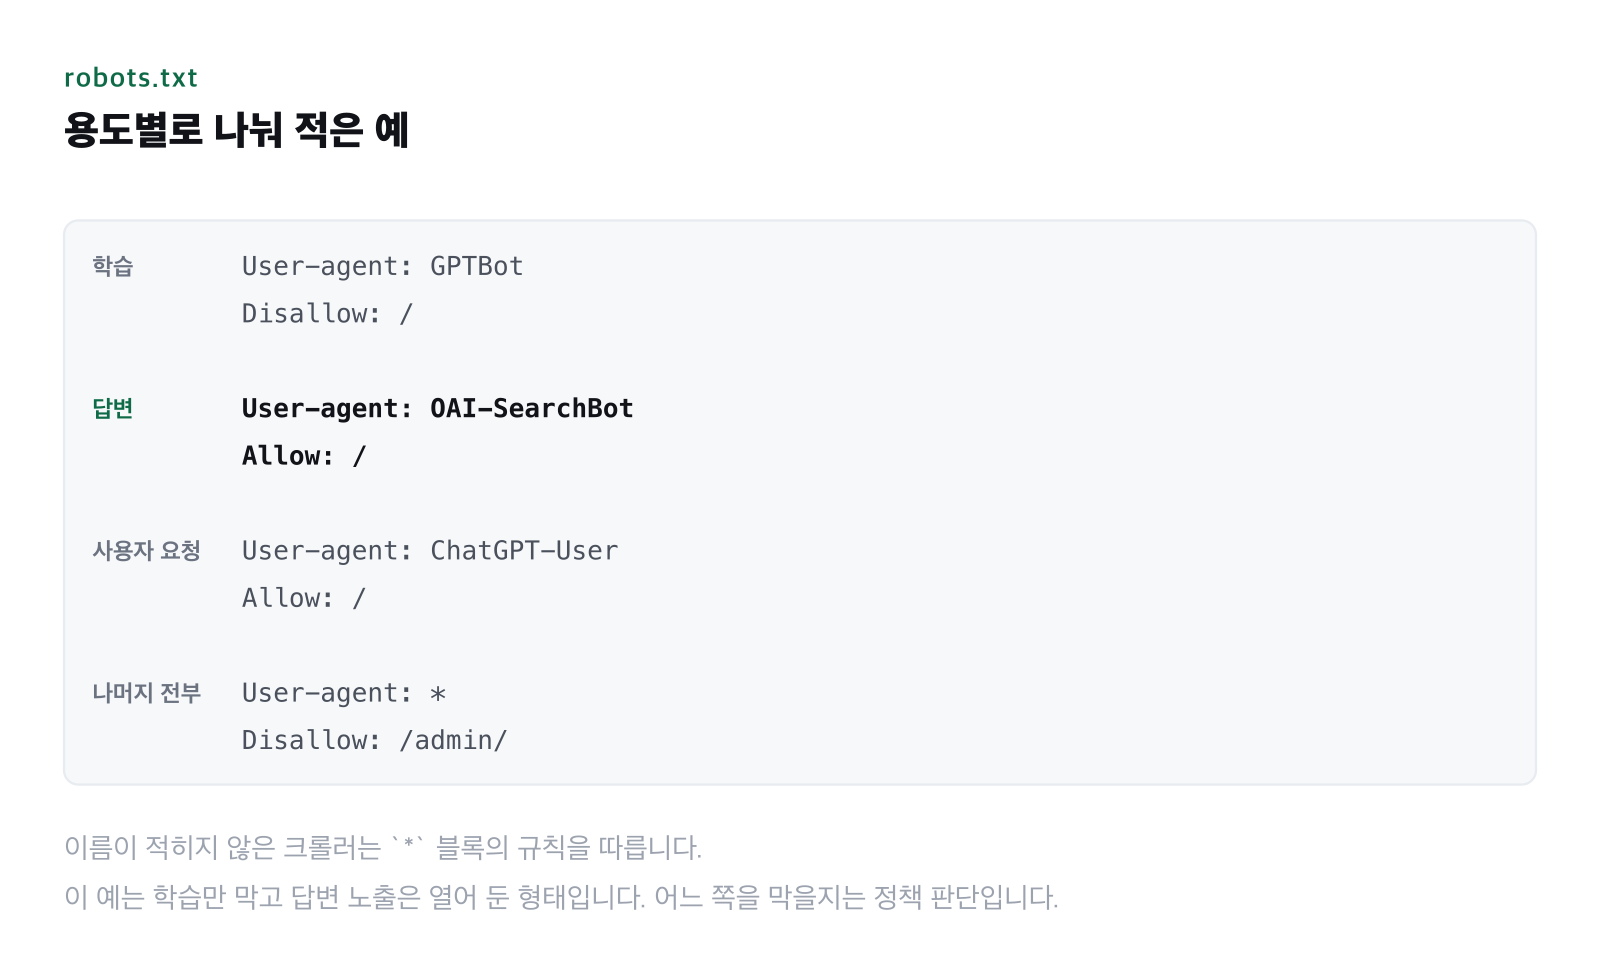
robots.txt에서 AI 수집기별 접근 규칙을 확인합니다. 사업자에 따라 학습용 수집, 검색용 수집, 사용자 요청에 따른 페이지 조회에 서로 다른 이름을 사용합니다.
수집기 이름과 용도 확인
설정할 수집기의 이름과 robots.txt 처리 방식은 변경 시점의 공식 문서를 기준으로 확인합니다.
| 사업자 | 공식 문서에서 확인할 이름 |
|---|---|
| OpenAI | GPTBot, OAI-SearchBot, ChatGPT-User |
| Anthropic | ClaudeBot, Claude-User, Claude-SearchBot |
| Perplexity | PerplexityBot과 사용자 요청 시점의 조회 |
| 검색 크롤러와 Google-Extended의 적용 범위 |
사업자별 안내: OpenAI, Anthropic, Perplexity.
각 수집기의 용도를 확인한 뒤 콘텐츠 정책에 맞춰 허용 범위를 정합니다. 학습용 수집 정책, 검색 노출에 사용할 공개 경로, 사용자 요청 시 조회할 경로를 각각 검토합니다.
현재 설정 대조
https://도메인/robots.txt를 열어 서버가 제공하는 원문을 확인합니다. 수집기 이름별 User-agent 블록과 Allow·Disallow 규칙을 적고, 해당 이름의 블록이 없는 경우에는 * 규칙도 확인합니다.
서버·CDN·방화벽의 봇 차단 설정과 접근 로그를 함께 봅니다. robots.txt에서 허용한 경로가 403 응답을 받는다면 해당 응답을 만든 설정을 찾아 수정합니다.
비공개 콘텐츠는 인증과 접근 권한으로 보호합니다. robots.txt에는 수집기에 요청할 공개 경로의 규칙을 작성합니다.
변경과 재확인
변경한 수집기 이름·경로·허용 여부와 판단 근거를 남깁니다. 배포 뒤 robots.txt 원문과 서버 응답을 다시 확인하고, 공식 문서가 개정되면 설정의 적용 범위를 재검토합니다.
답변 노출은 질문·모델·수집 시점과 함께 기록합니다. 접근 설정을 바꾼 날짜를 표시해 이후 브랜드 언급과 인용 URL을 비교합니다.
같은 주제의 다른 글
기술 점검- 기술 점검
페이지 속도와 수집 실패 구분하기
수집 실패가 발생하면 HTTP 응답과 서버 대기 시간을 확인합니다. 화면 표시 지표는 사용자 화면의 상태를 측정하므로 각 값의 측정 대상과 조건을 구분해 기록합니다.
- 기술 점검
초기 HTML의 본문 확인하기
브라우저에 보이는 본문이 초기 HTTP 응답에도 들어 있는지 확인합니다. 페이지 소스와 렌더링 결과를 비교한 뒤 본문·탭·링크의 수정 위치를 정합니다.
- 기술 점검
페이지 접근·색인 점검표
공개 페이지의 응답 코드와 색인 지시어, robots.txt 규칙을 확인합니다. canonical·sitemap·중복 주소까지 대조해 수정할 주소와 담당자를 정합니다.