robots.txt에서 AI 크롤러를 어떻게 다루고 있나 — 30분 점검 순서
AI 사업자는 학습용 수집과 답변용 수집에 서로 다른 크롤러 이름을 씁니다. 한 줄로 전부 막으면 답변 노출까지 함께 막힙니다. 사업자별 크롤러 이름을 구분하고 현재 규칙을 확인하는 순서를 정리했습니다.
AI 답변에 사이트가 인용되지 않는 이유를 찾을 때 가장 먼저 볼 자리는 robots.txt입니다. 여기서 막혀 있으면 콘텐츠를 어떻게 고쳐도 답변에 들어가지 않습니다.
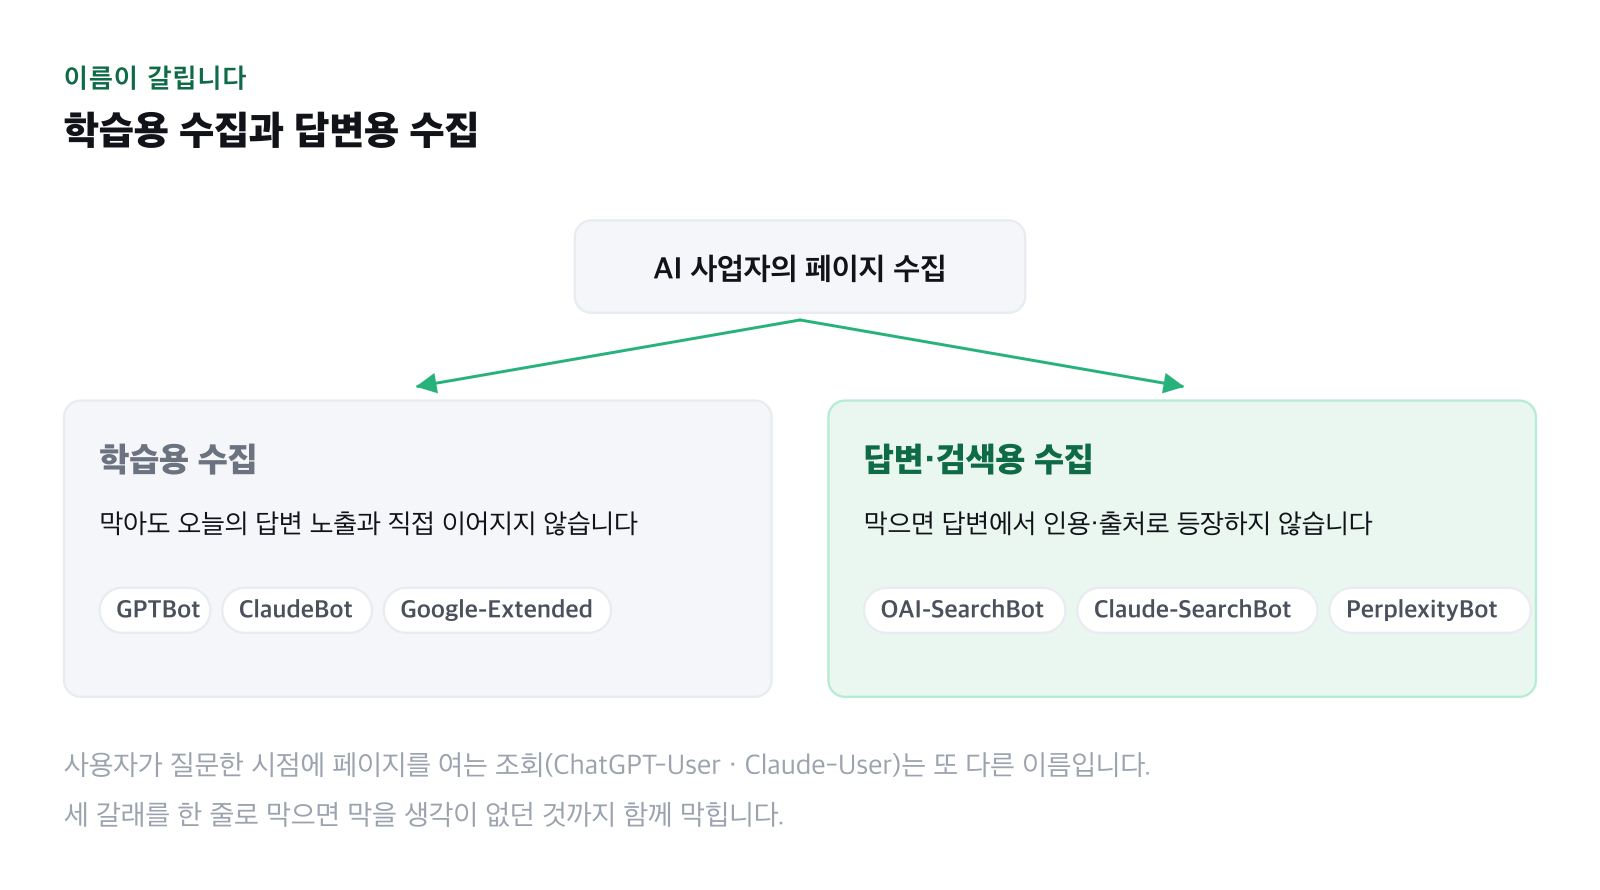
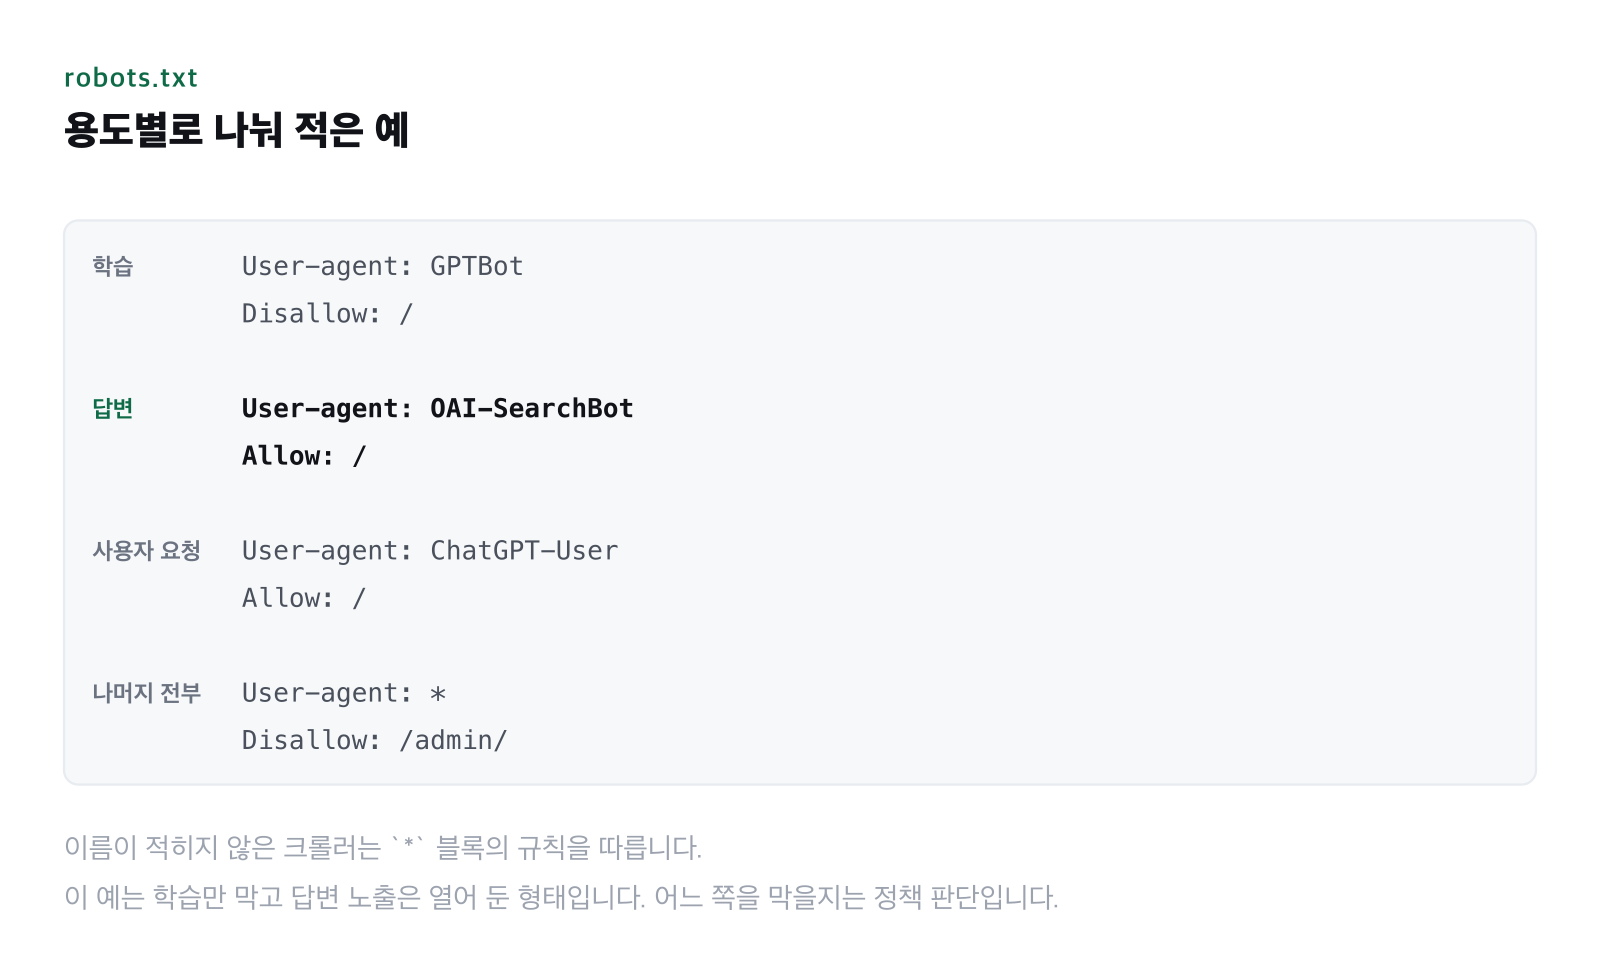
주의할 점은 AI 사업자들이 용도별로 크롤러 이름을 따로 둔다는 것입니다. 학습 데이터 수집과 답변 생성 시점의 페이지 조회가 다른 이름으로 옵니다. User-agent: *로 한 번에 막으면 두 가지가 같이 막힙니다.
사업자별로 이름이 갈립니다
OpenAI는 용도별로 크롤러를 나눠 문서화합니다. 모델 학습용 수집(GPTBot), 검색 결과에 사이트를 노출하기 위한 수집(OAI-SearchBot), 사용자가 질문했을 때 페이지를 직접 열어 보는 조회(ChatGPT-User)가 각각 다른 이름입니다. OpenAI 크롤러 개요 문서
Anthropic도 셋으로 나눕니다. 학습용 ClaudeBot, 사용자 질문 시점의 조회 Claude-User, 검색 색인용 Claude-SearchBot입니다. 각각을 robots.txt에서 따로 처리할 수 있고 세 이름 모두 robots.txt를 읽는다고 안내합니다. Anthropic 크롤러 안내 문서
Perplexity는 색인용 PerplexityBot과 사용자 요청 시점의 조회를 나눠 두고 있습니다. Perplexity 크롤러 문서
Google은 검색 크롤링과 생성형 AI 학습 활용을 분리해, Google-Extended로 학습 활용만 따로 거절할 수 있게 했습니다. 이 이름은 검색 색인이나 순위와는 별개로 동작합니다.
그래서 이 판단을 나눠서 해야 합니다
| 결정할 것 | 막으면 생기는 일 | 판단 기준 |
|---|---|---|
| 학습용 수집 허용 여부 | 향후 모델 학습 데이터에서 빠집니다. 오늘의 답변 노출과 직접 연결되지는 않습니다 | 콘텐츠 정책, 저작권, 유료 콘텐츠 여부 |
| 답변·검색용 수집 허용 여부 | 답변에서 인용·출처로 등장하지 않게 됩니다 | 노출을 원하는지 여부 |
| 사용자 요청 시점 조회 허용 여부 | 사용자가 우리 주소를 직접 물어도 내용을 못 읽습니다 | 고객 문의 대응 경로로 쓰이는지 |
세 줄을 같은 판단으로 처리하지 않아야 합니다. 실제로 자주 보는 상태는 "학습은 막고 싶었는데 답변 노출까지 막힌" 경우입니다.
30분 점검 순서
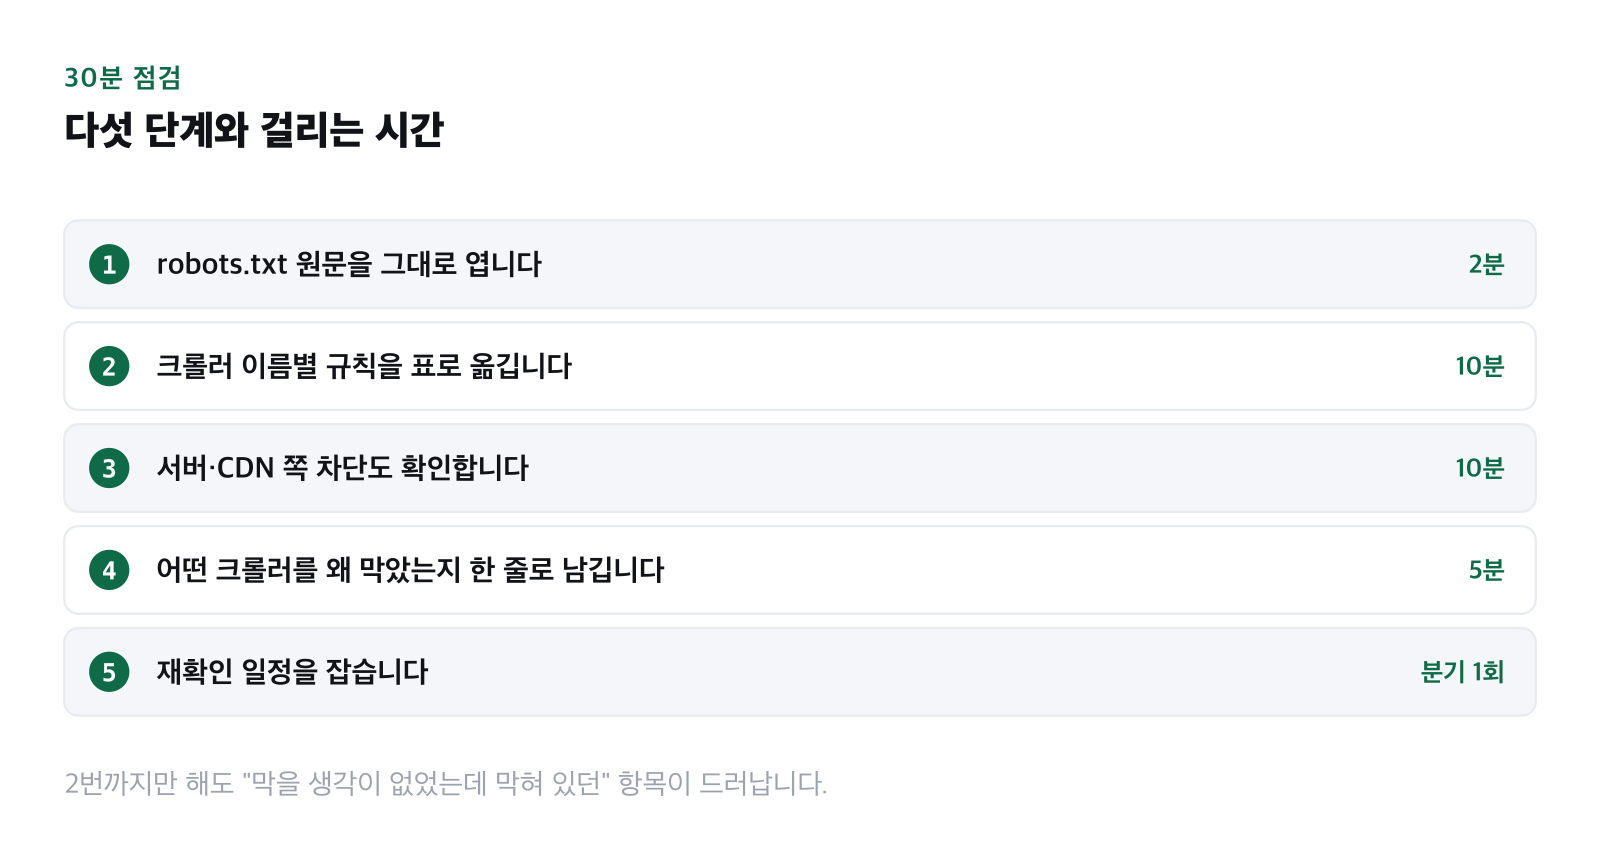
- robots.txt 원문을 그대로 엽니다(약 2분).
https://도메인/robots.txt입니다. 관리 도구의 설정 화면이 아니라 실제로 서버가 내보내는 파일을 봅니다. - 크롤러 이름별로 규칙을 표에 옮깁니다(약 10분).
User-agent블록마다 어떤Disallow가 붙어 있는지 적습니다. 이름이 없는 크롤러는*블록의 규칙을 따릅니다. - 서버와 CDN 쪽 차단도 확인합니다(약 10분). robots.txt는 허용인데 방화벽이나 봇 차단 규칙에서 403을 주는 경우가 있습니다. 이쪽이 원인이면 robots.txt를 고쳐도 달라지지 않습니다.
- 판단 근거를 한 줄로 남깁니다(약 5분). 어떤 크롤러를 왜 막았는지 기록이 없으면 다음 담당자가 되돌리거나 그대로 방치합니다.
- 재확인 일정을 잡습니다. 크롤러 이름과 정책은 사업자가 바꿉니다. 분기에 한 번 공식 문서를 다시 봅니다.
확인할 때 주의할 점
- 문서가 바뀝니다. 사용자 요청 시점 조회의 robots.txt 처리 표현이 개정된 사례가 있습니다. 글에서 본 설명이 아니라 게시 시점의 공식 문서를 근거로 삼아야 합니다.
- robots.txt는 접근 통제가 아닙니다. 규칙을 읽지 않는 수집기도 있습니다. 반드시 막아야 하는 콘텐츠는 인증 뒤에 둡니다.
- 한 줄 차단은 되돌리기 쉽지만 결과 확인은 느립니다. 규칙을 고친 뒤 답변 노출이 달라지는지 보려면 질문 관찰 기록이 필요합니다.
먼저 2번까지만 해 보시면 됩니다. 크롤러 이름별 규칙을 표로 옮기는 것만으로 "막을 생각이 없었는데 막혀 있던" 항목이 드러나는 경우가 많습니다.
같은 주제의 다른 글
기술 점검- 기술 점검
페이지 속도는 AI 검색에서 무엇을 하고 무엇을 하지 않나
속도를 올리면 AI 답변에 더 인용된다는 근거는 없습니다. 다만 응답이 느리거나 실패하면 수집 자체가 끊깁니다. 속도 지표를 인용 성과가 아니라 수집 성공률 문제로 다루는 방법과, 측정값이 비어 있을 때의 해석을 정리했습니다.
- 기술 점검
자바스크립트로 그리는 페이지는 AI에게 어떻게 보이나 — 본문 노출 확인법
화면에는 글이 보이는데 HTML에는 없는 페이지가 있습니다. 이런 페이지는 수집 단계에서 빈 문서로 취급될 수 있습니다. 본문이 HTML에 있는지 확인하는 세 가지 방법과, 전면 재구축 없이 손보는 순서를 정리했습니다.
- 기술 점검
AI가 페이지를 못 읽는 흔한 원인 6가지 — 색인성 점검 목록
콘텐츠를 고치기 전에 페이지가 읽히는 상태인지 확인해야 합니다. noindex, 표준 주소 오지정, 리다이렉트 사슬, sitemap 불일치처럼 실무에서 반복해 나오는 여섯 가지 원인과 각각의 확인 방법을 정리했습니다.