AI가 답을 만드는 4단계 — 어느 단계에 우리가 손댈 수 있나
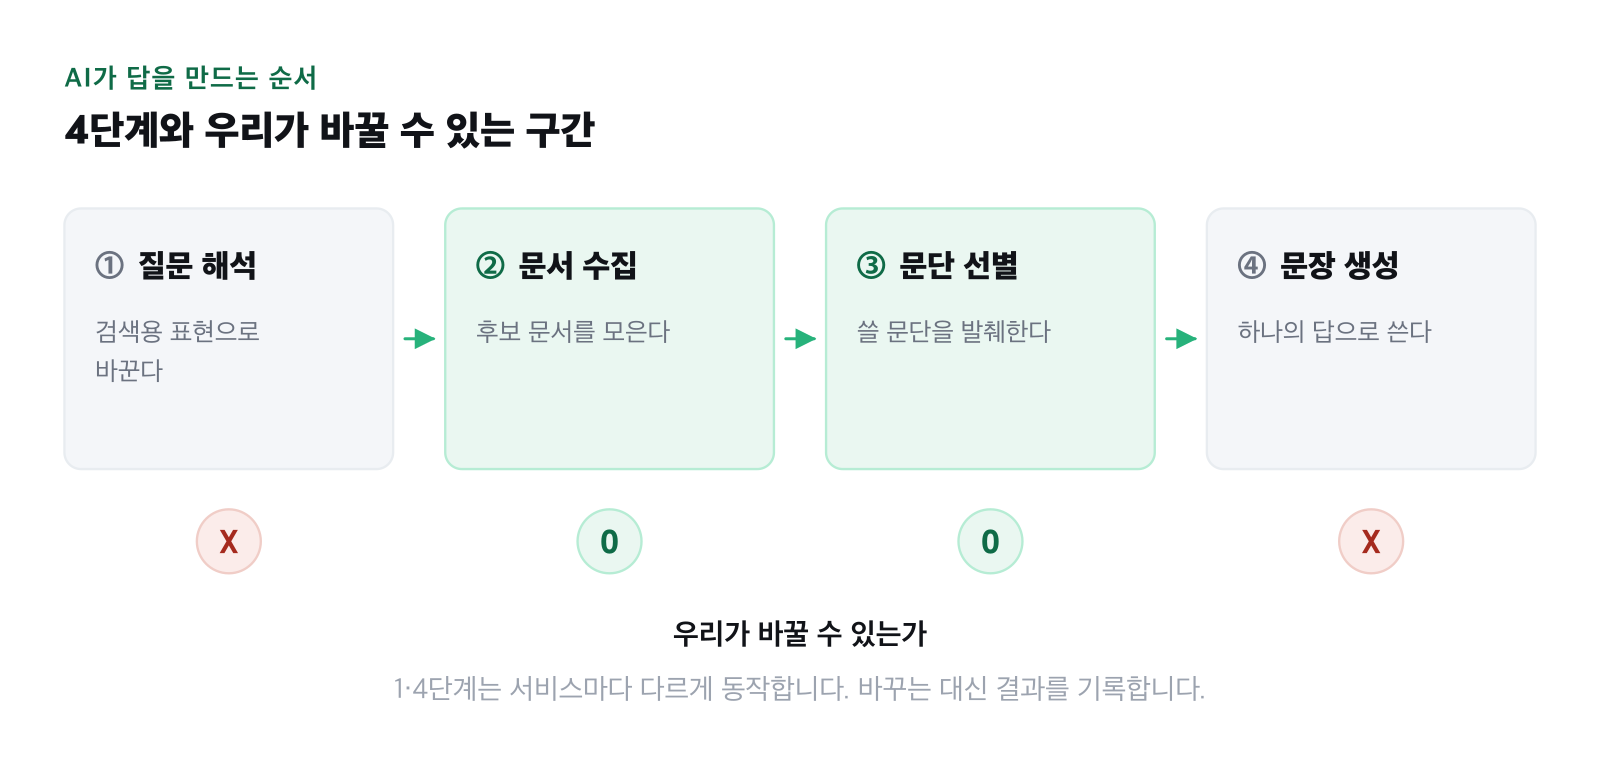
생성형 검색은 질문 해석, 문서 수집, 문단 선별, 문장 생성의 순서로 답을 만듭니다. 네 단계 중 사이트 운영자가 실제로 바꿀 수 있는 구간과, 바꿀 수 없어서 관찰만 해야 하는 구간을 나눠 정리했습니다.
생성형 검색이 답을 내놓기까지는 크게 네 단계를 지납니다. 질문을 해석하고, 문서를 모으고, 그중 쓸 문단을 고르고, 문장으로 씁니다. 이 중 사이트 운영자가 실제로 바꿀 수 있는 구간은 두 번째와 세 번째뿐입니다.
첫 번째와 네 번째 단계는 서비스마다 다르게 동작하고 공개되지 않은 부분이 많습니다. 그래서 이 구간은 바꾸려 하지 않고 결과를 기록해 두는 편이 정확합니다.
1단계. 질문 해석 — 손댈 수 없는 구간
사용자가 "직원 50명 회사에 맞는 근태 관리 도구"라고 물으면, 서비스는 이 문장을 자기 검색용 표현 몇 개로 바꿉니다. 어떤 표현으로 바꾸는지는 공개되지 않고 같은 질문에도 매번 같지 않습니다.
여기서 할 수 있는 일은 표현을 맞추는 것이 아니라, 고객이 실제로 쓰는 질문 문장을 목록으로 확보하는 것입니다. 이 목록이 나중에 관찰 대상이 됩니다.
2단계. 문서 수집 — 접근이 갈리는 구간
바꾼 표현으로 문서를 모읍니다. 이때 세 갈래가 있습니다.
- 검색 엔진의 결과를 그대로 받아 오는 경우
- 사업자가 따로 만든 색인에서 찾는 경우
- 질문을 받은 시점에 페이지를 직접 열어 보는 경우
세 갈래 모두 robots.txt 규칙을 읽습니다. 학습용 수집과 답변용 수집에 다른 크롤러 이름을 쓰는 사업자도 있어서, 한 줄로 전부 막거나 전부 여는 판단이 잘 맞지 않습니다.
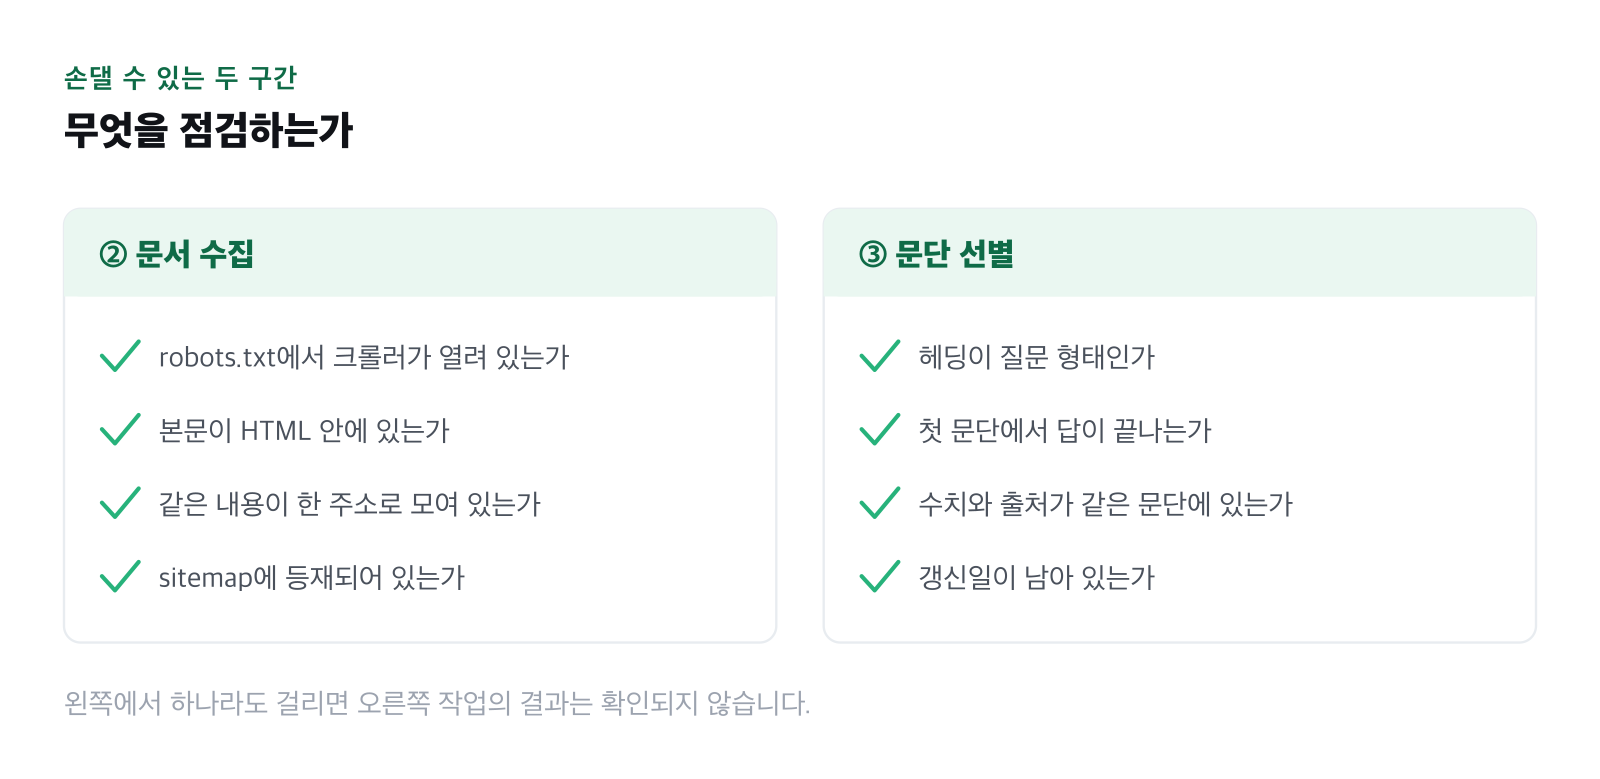
이 단계에서 우리 페이지가 후보에 들어가려면 최소한 세 가지가 성립해야 합니다. 크롤러 접근이 막혀 있지 않고, 본문이 HTML 안에 있고, 같은 내용이 여러 주소로 흩어져 있지 않아야 합니다.
3단계. 문단 선별 — 글 구조가 갈리는 구간
모은 문서 전체를 답에 쓰지는 않습니다. 질문에 대응하는 부분만 발췌합니다. 그래서 발췌할 단위가 페이지 안에 있는지가 이 단계를 가릅니다.
발췌 단위가 있는 글은 이렇게 생겼습니다.
- 헤딩이 질문 형태입니다.
가격은 어떻게 계산되나요 - 그 바로 아래 첫 문단에서 답이 끝납니다. 두세 문장입니다.
- 근거가 필요한 문장에는 수치와 출처가 같은 문단에 있습니다.
- 조건이 여러 개면 표나 번호 목록으로 끊어 둡니다.
반대로 결론이 페이지 마지막에 있고 그 앞이 배경 설명이면, 발췌할 두세 문장을 고르기 어렵습니다.
4단계. 문장 생성 — 다시 손댈 수 없는 구간
고른 문단들을 하나의 답으로 씁니다. 어떤 순서로 브랜드를 나열하는지, 출처를 몇 개 붙이는지는 서비스와 시점에 따라 달라집니다.
같은 질문을 하루에 다섯 번 물어 보면 이 차이가 그대로 보입니다.
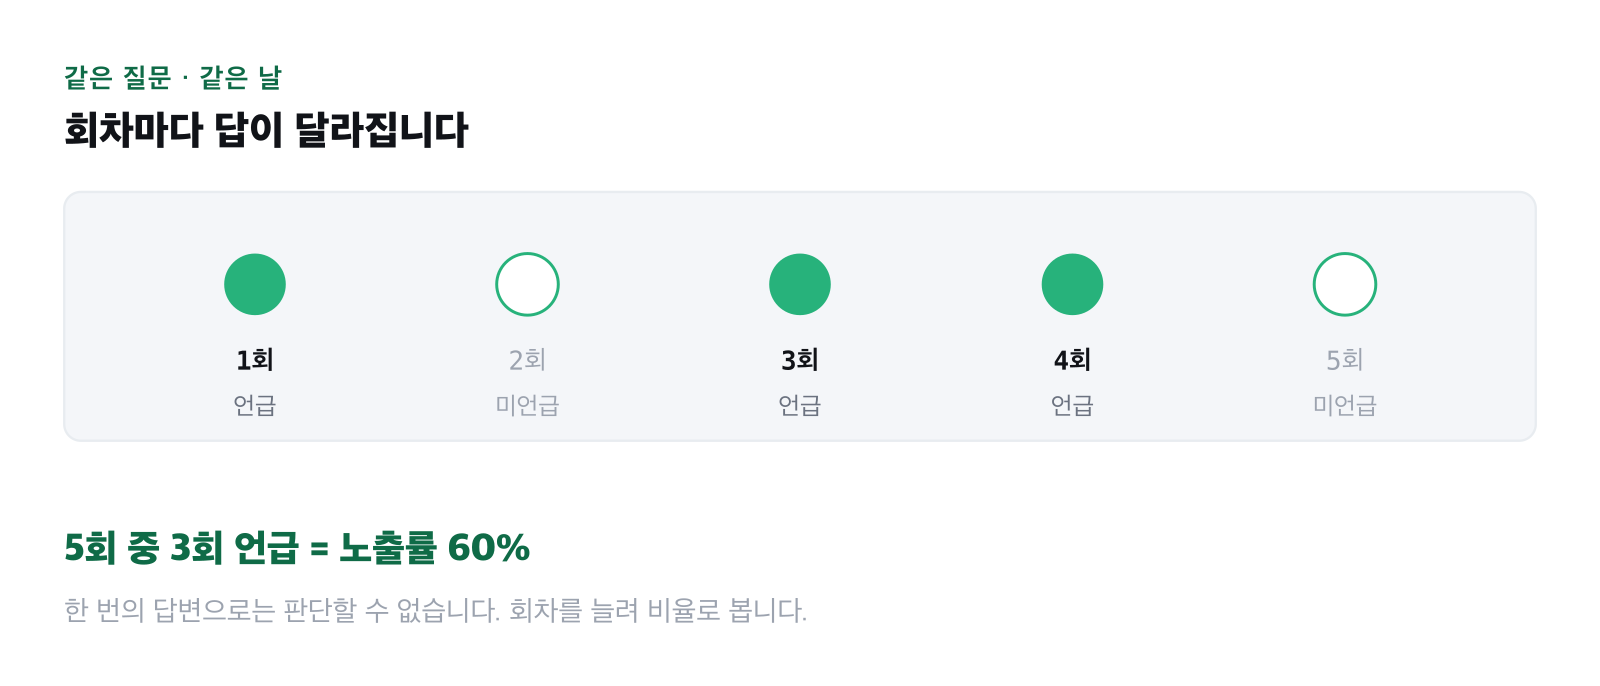
한 번의 답변으로는 노출 여부를 판단할 수 없습니다. 회차를 늘려 비율로 봐야 흔들림과 실제 변화가 구분됩니다.
그래서 작업 순서는 이렇게 됩니다
- 2단계용 작업: robots.txt 규칙 확인, 본문의 HTML 노출 확인, 표준 주소 정리, sitemap 등재
- 3단계용 작업: 핵심 페이지의 질문형 헤딩과 첫 문단 답변, 수치의 출처 표기, 갱신일
- 1·4단계용 작업: 바꾸는 대신 기록합니다. 질문 목록을 정하고 답변을 주기적으로 저장해 언급 비율의 변화를 봅니다
바꿀 수 있는 구간을 먼저 정리하고, 바꿀 수 없는 구간은 관찰 대상으로 돌리는 것이 순서입니다. 이번 주에 할 일 하나를 고른다면 2단계의 robots.txt 확인이 가장 빠릅니다.
같은 주제의 다른 글
개념- 개념
노출률·평균 순위·표본 수 — AI 가시성 지표를 잘못 읽는 세 가지 방식
AI 답변 관찰 결과는 순위표처럼 읽으면 틀립니다. 노출률과 평균 순위가 각각 무엇을 세는 값인지, 표본 수를 함께 보지 않으면 어떤 착각이 생기는지, 언급 위치와 명시 순위를 왜 구분하는지 정리했습니다.
- 개념
SEO, AEO, GEO는 무엇이 다른가 — 목표·측정·작업 항목으로 구분하기
세 용어는 대체 관계가 아니라 목표가 다른 세 작업입니다. 무엇을 성과로 보는지, 무엇으로 측정하는지, 실제로 손대는 항목이 무엇인지 세 축으로 나눠 비교하고, 어느 순서로 손대야 하는지 정리했습니다.
- 개념
GEO(생성형 엔진 최적화)란 무엇인가 — SEO와 겹치는 것, 갈라지는 것
GEO는 ChatGPT·Perplexity·AI 개요 같은 생성형 검색이 답을 쓸 때 우리 사이트 내용을 가져다 쓰고 브랜드 이름을 함께 적게 만드는 작업입니다. 순위 경쟁과 무엇이 같고 어디서 갈라지는지, 실제로 손대는 영역 네 가지를 정리했습니다.